Cara Mengatasi Indexed, Though Blocked by robots.txt Tanpa Ribet

durasi baca : 2 menit
Pernah membuka Google Search Console lalu menemukan peringatan indexed though blocked by robots txt? Bagi pemilik website, terutama yang baru belajar SEO, notifikasi ini seringkali membingungkan. Banyak yang mengira website sedang mengalami masalah besar, padahal belum tentu demikian.
Pada dasarnya, status indexed though blocked by robots txt menunjukkan bahwa Google berhasil mengindeks sebuah halaman meskipun halaman tersebut diblokir oleh file robots.txt. Lalu, apa sebenarnya penyebabnya? Apakah status ini berbahaya? Dan bagaimana cara mengatasinya? Yuk simak penjelasannya di sini!
Apa Itu Indexed Though Blocked by robots txt?
Sebelum memahami apa itu indexed though blocked by robots txt, kamu perlu mengetahui terlebih dahulu fungsi dari robots.txt. Robots.txt adalah sebuah file yang berisi sekumpulan instruksi untuk bot mesin pencari (crawler), seperti Googlebot, mengenai halaman atau folder mana yang boleh dan tidak boleh diakses saat proses crawling website.
Sederhananya, file ini berfungsi sebagai petunjuk jalan yang membantu mesin pencari memahami bagian mana dari website yang dapat dijelajahi.
Nah, indexed though blocked by robots txt adalah status di Google Search Console yang menunjukkan bahwa Google telah mengindeks sebuah halaman meskipun halaman tersebut diblokir oleh robots.txt. Hal ini bisa terjadi karena Google sudah mengetahui URL tersebut, tetapi tidak dapat mengakses isi halamannya akibat aturan yang terdapat di file robots.txt.
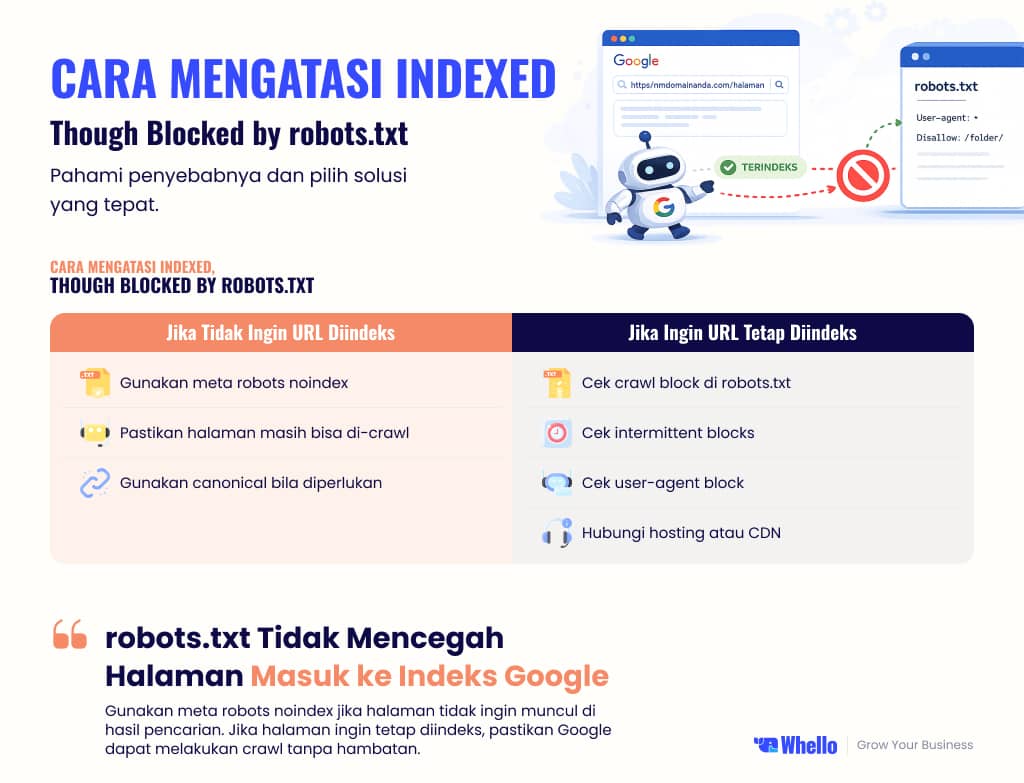
Dengan kata lain, file robots.txt tidak mencegah halaman masuk ke indeks Google, melainkan hanya mencegah crawler membaca kontennya. Jika tujuan kamu adalah agar sebuah halaman benar-benar tidak muncul di hasil pencarian, penggunaan meta robots noindex biasanya menjadi solusi yang lebih tepat dibandingkan hanya memblokirnya melalui robots.txt.
Cara Mengatasi Indexed Though Blocked by robots txt
Pesan indexed though blocked by robots.txt di Google Search Console muncul ketika Google sudah mengindeks sebuah URL, tetapi tidak dapat melakukan crawl karena URL tersebut diblokir oleh file robots.txt.
Kondisi ini bisa terjadi karena Google masih mengetahui URL tersebut dari internal link, backlink, sitemap, atau hasil crawling sebelumnya. Oleh karena itu, cara mengatasinya tergantung pada tujuan kamu: apakah URL tersebut memang ingin diindeks atau justru ingin dihapus dari hasil pencarian.
1. Jika Tidak Ingin URL Diindeks
Apabila halaman tersebut memang tidak ingin muncul di hasil pencarian Google, jangan hanya mengandalkan file robots.txt. Sebaiknya gunakan meta robots noindex agar Google mengetahui bahwa halaman tersebut tidak boleh dimasukkan ke dalam indeks.
Pastikan juga halaman masih dapat di-crawl oleh Google. Alasannya, jika crawler diblokir melalui robots.txt, Google tidak akan bisa membaca tag noindex yang ada di halaman tersebut. Akibatnya, URL masih berpotensi tetap terindeks karena Google menemukannya melalui tautan dari halaman lain atau backlink.
Selain itu, jika beberapa URL sudah menggunakan canonical tag yang mengarah ke satu halaman utama, biasanya kamu tidak perlu menambahkan tag noindex pada URL tersebut. Canonical sudah memberi tahu Google halaman mana yang sebaiknya dijadikan versi utama untuk diindeks.
2. Jika Ingin URL Tetap Diindeks
Sebaliknya, jika halaman tersebut memang penting dan ingin muncul di hasil pencarian, kamu perlu mencari tahu mengapa Google tidak dapat melakukan crawl.
Langkah pertama adalah memeriksa apakah ada aturan di file robots.txt atau konfigurasi lain yang secara tidak sengaja memblokir akses Googlebot. Setelah penyebabnya ditemukan, hapus aturan pemblokiran tersebut agar Google dapat melakukan crawl dan memperbarui indeks halaman.
- Cek Crawl Block di robots.txt
Penyebab paling umum munculnya indexed though blocked by robots txt adalah adanya aturan Disallow di file robots.txt.
Kamu bisa memeriksa file ini melalui Google Search Console menggunakan fitur robots.txt Tester atau langsung membuka alamat namadomainanda.com/robots.txt. Perhatikan apakah terdapat aturan seperti berikut:
User-agent: *
Disallow: /
Aturan tersebut berarti semua crawler, termasuk Googlebot, dilarang mengakses seluruh isi website. Jika ternyata aturan ini tidak disengaja, kamu cukup menghapus atau memperbaikinya sesuai kebutuhan.
Bagi pengguna WordPress, penyebabnya juga bisa berasal dari pengaturan Search Engine Visibility. Masuk ke Settings > Reading, lalu pastikan opsi “Discourage search engines from indexing this site” atau “Search Engine Visibility” dalam keadaan tidak dicentang.
- Cek Intermittent Blocks
Terkadang masalah tidak terjadi secara terus-menerus, melainkan hanya muncul pada waktu tertentu. Kondisi ini disebut intermittent blocks. Biasanya, penyebabnya adalah perubahan sementara pada file robots.txt, cache, proses maintenance, atau konfigurasi server yang berubah-ubah.
Untuk memeriksanya, kamu bisa melihat riwayat file robots.txt melalui Google Search Console jika tersedia, atau menggunakan layanan seperti Wayback Machine di Archive.org untuk melihat versi file robots.txt pada tanggal-tanggal sebelumnya.
Dengan begitu, kamu dapat mengetahui apakah pernah ada aturan pemblokiran yang menyebabkan Google gagal melakukan crawl.
Jika penyebabnya berasal dari sistem cache, misalnya file robots.txt yang tersimpan dalam cache saat proses pengujian, solusinya adalah mengecualikan file robots.txt dari sistem cache agar Google selalu membaca versi terbaru.
- Cek User-Agent Block
Selain robots.txt, penyebab lain yang cukup sering terjadi adalah adanya pemblokiran terhadap user-agent tertentu, misalnya Googlebot. Dalam kondisi ini, halaman website terlihat normal saat dibuka melalui browser, tetapi ketika diakses menggunakan identitas Googlebot, server justru menolaknya.
Kamu dapat melakukan pengecekan menggunakan Chrome DevTools atau ekstensi browser yang memungkinkan mengganti user-agent menjadi Googlebot.
Jika setelah diganti halaman tidak bisa diakses, berarti ada aturan yang secara khusus memblokir crawler Google. Biasanya pemblokiran seperti ini berasal dari file .htaccess, firewall, konfigurasi server, CDN, atau sistem keamanan yang disediakan oleh penyedia hosting.
- Hubungi Penyedia Hosting atau CDN Jika Diperlukan
Jika setelah diperiksa tidak ada masalah pada robots.txt, tetapi Googlebot tetap diblokir, kemungkinan penyebabnya berasal dari sisi server atau layanan keamanan yang kamu gunakan.
Misalnya firewall hosting, CDN, atau sistem keamanan otomatis yang menganggap Googlebot sebagai bot yang mencurigakan. Dalam kondisi seperti ini, solusi terbaik adalah menghubungi penyedia hosting atau layanan CDN yang digunakan.
Mintalah mereka memeriksa apakah terdapat aturan keamanan yang memblokir Googlebot dan meminta bantuan untuk menghapus atau menyesuaikan aturan tersebut. Dengan begitu, Google dapat kembali melakukan crawl tanpa hambatan.
Yuk, Cek Website Kamu dengan Jasa SEO Whello Sekarang!
Dengan memahami penyebab dan menerapkan cara mengatasi indexed though blocked by robots txt yang tepat, kamu dapat menjaga website tetap sehat, lebih mudah dipahami oleh mesin pencari, dan mendukung performa SEO dalam jangka panjang.
Jika ingin website tidak hanya bebas dari masalah teknis seperti indexed though blocked by robots txt, tetapi juga mampu bersaing di halaman pertama Google, menggunakan jasa SEO dari Whello bisa menjadi solusi yang tepat.
Tim Whello akan membantu mengoptimalkan website secara menyeluruh, mulai dari technical SEO, riset keyword, optimasi konten, hingga meningkatkan performa website agar lebih mudah ditemukan oleh calon pelanggan.
Dengan strategi yang disesuaikan dengan kebutuhan bisnis, kamu tidak hanya mendapatkan trafik yang lebih berkualitas, tetapi juga peluang konversi yang lebih besar. Yuk konsultasi dulu dengan tim Whello sekarang, gratis kok!
Frequently Asked Questions
Periksa terlebih dahulu apakah URL tersebut memang ingin diindeks. Jika ya, hapus aturan pemblokiran di robots.txt. Jika tidak, gunakan tag noindex dan biarkan Google melakukan crawl agar perubahan dapat terdeteksi.
Suka Artikel Ini?
Subscribe Newsletter Whello Gratis
Dapatkan promo eksklusif dan konten menarik langsung di emailmu.

Tentang Sylvia Paramitha
Copywriter
Hai! Kenalin aku Sylvia Paramitha, copywriter alias orang dibalik kata-kata kreatif di Whello Indonesia. Yuk kenalan!